

Bild wurde mit Hilfe von AI generiert
Wird der Entwickler überflüssig?
Mit dem richtigen Setup aus Projektwissen, Anweisungen, Werkzeugen und Grenzen, wie in Teil 3 unserer Blogserie beschrieben, kann ein AI-Agent Aufgaben planen, Code schreiben und seine Änderungen selbst testen. Damit stellt sich eine naheliegende Frage: Wofür braucht ein Team dann noch Entwickler?
Ein Agent, der eine Lösung umsetzt, entscheidet damit noch nicht, ob sie die richtige ist. Dafür muss jemand die Anforderungen verstehen, Auswirkungen auf das bestehende System beurteilen und prüfen, ob das Ergebnis im Betrieb bestehen kann. Tests helfen dabei. Sie zeigen aber nur das, was sie tatsächlich prüfen.
Entwickler werden deshalb nicht automatisch überflüssig. Ihre Arbeit verändert sich dort, wo Agenten Teile der Umsetzung übernehmen: Sie beschreiben Aufgaben, legen Grenzen fest und prüfen die Ergebnisse. Wenn sie Code nicht mehr selbst schreiben, müssen sie ihn dennoch verstehen und beurteilen können. Diese systematische Entwicklung von Software mit AI-Agenten steht im Mittelpunkt von Agentic Engineering.
Der Artikel zeigt diesen Wandel in drei Schritten: wie Agenten Aufgaben bearbeiten, wie Menschen ihren Handlungsspielraum und die nötigen Freigaben festlegen und was das für die Zusammenarbeit und die Fähigkeiten im Entwicklerteam bedeutet.
Wie Agenten arbeiten: Schleifen, Entscheidungen und Arbeitsteilung
Der Loop: Umsetzen, prüfen, verbessern
Ein Agent soll eine Terminbuchung so anpassen, dass zwei Kunden nicht denselben Termin buchen können. Er untersucht die bestehende Logik, setzt eine Änderung um und testet, was bei zwei gleichzeitigen Buchungsversuchen passiert. Schlägt der Test fehl, korrigiert er die Lösung und prüft sie erneut. Dieser wiederholte Ablauf heißt Loop.
Damit der Agent nicht endlos weiterarbeitet, braucht er ein klares Prüfkriterium und eine Abbruchregel. Für die Terminbuchung könnte das Kriterium lauten: Bei zwei gleichzeitigen Buchungsversuchen wird genau eine Buchung bestätigt, die andere wird abgewiesen. Eine Abbruchregel begrenzt beispielsweise die Zahl der Versuche, die Laufzeit oder die Kosten. Erreicht der Agent diese Grenze, ohne die Aufgabe zu lösen, muss er anhalten und das ungelöste Problem melden.
Ein bestandener Test bedeutet allerdings noch nicht, dass die gesamte Lösung korrekt ist. Er bestätigt zunächst nur, dass das geprüfte Verhalten unter den jeweiligen Testbedingungen funktioniert.
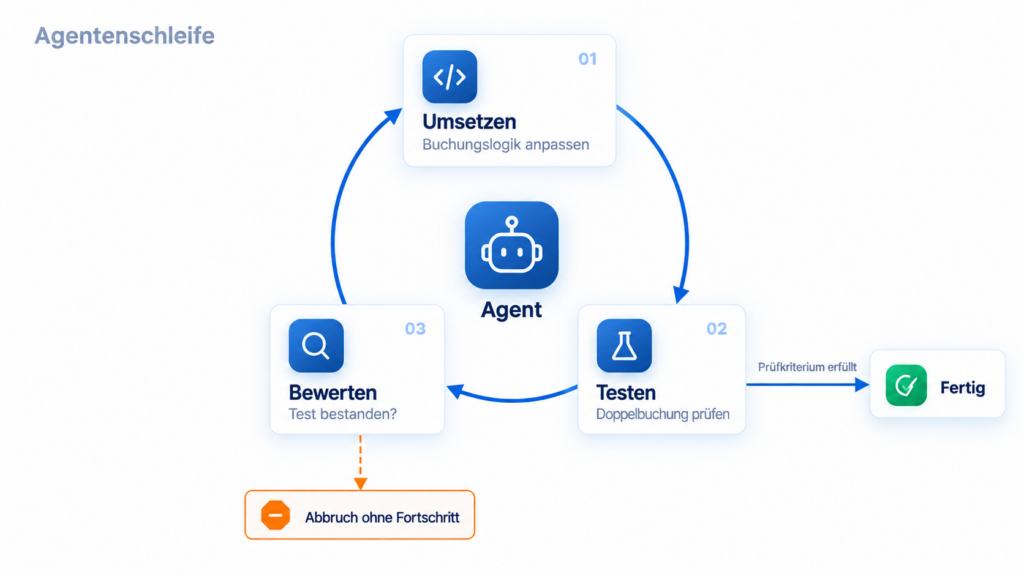
Bild wurde mit Hilfe von AI generiert
Der Graph: Wenn der Ablauf verzweigt
Nicht jedes Problem lässt sich lösen, indem der Agent denselben Schritt wiederholt. Manchmal muss er den Plan ändern, zusätzliche Informationen beschaffen oder eine Entscheidung des Menschen abwarten.
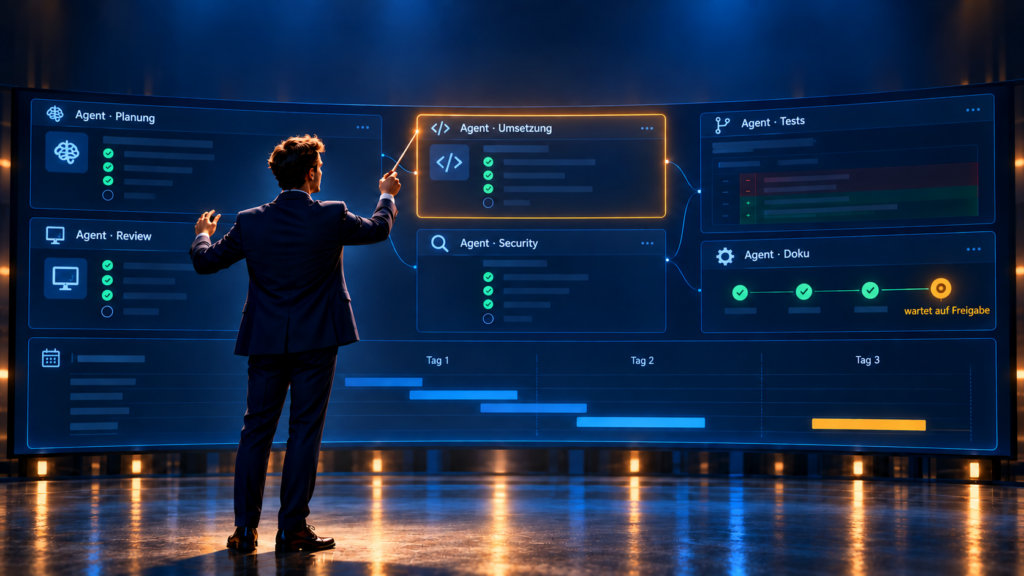
Solche Abläufe lassen sich als Graph darstellen: Die einzelnen Schritte bilden die Knoten, die Verbindungen zeigen die möglichen Wege dazwischen. Welche Verbindung der Agent nimmt, hängt vom Ergebnis eines Schritts oder von festgelegten Bedingungen ab.
Bei der Terminbuchung führt ein fehlgeschlagener Test zurück zur Umsetzung. Zeigt sich dabei, dass der Lösungsansatz ungeeignet ist, geht es zurück zur Planung. Sind die vorgesehenen Prüfungen bestanden, kann die Änderung zur menschlichen Freigabe vorgelegt werden.
Der Loop verschwindet dabei nicht. Er ist Teil eines größeren Ablaufs mit unterschiedlichen Rückwegen und Entscheidungspunkten.
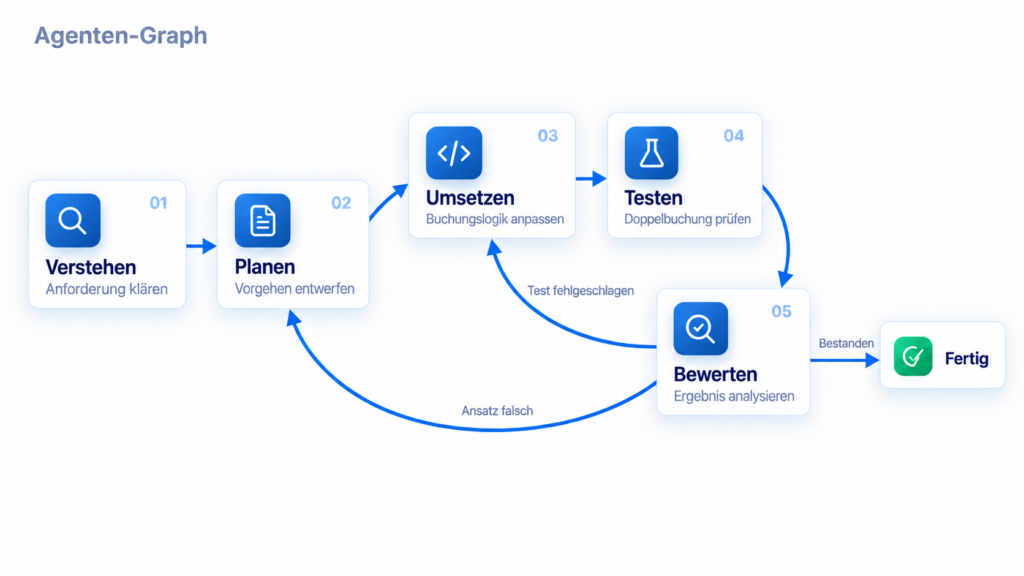
Bild wurde mit Hilfe von AI generiert
Mehrere Agenten teilen sich die Arbeit
Ein solcher Ablauf braucht nicht automatisch mehrere Agenten. Ein einzelner Agent kann die Buchungslogik untersuchen, eine Änderung umsetzen und Tests ausführen. Bei umfangreicheren Aufgaben lassen sich diese Schritte auf spezialisierte Agenten verteilen: Einer analysiert den bestehenden Code, ein zweiter setzt die Änderung um, ein dritter prüft das Ergebnis.
Arbeiten mehrere Agenten koordiniert an einer Aufgabe, spricht man von einem Multi-Agent-System. Die Aufteilung ist aber kein Vorteil an sich. Die Agenten müssen Informationen übergeben, Ergebnisse abgleichen und mit Widersprüchen umgehen. Das kostet Zeit und Ressourcen und schafft zusätzliche Fehlerquellen. Auch ein separater Prüfagent kann Fehler übersehen.
Entscheidend ist deshalb nicht, wie viele Agenten beteiligt sind, sondern ob die Arbeitsteilung die Aufgabe nachweislich besser lösbar macht. Für beide Varianten bleibt dieselbe Frage: Wer legt fest, was die Agenten tun dürfen und wann ein Mensch entscheiden muss?
Was der Mensch festlegt: Ziele, Grenzen und Freigaben
Der Agent kann einen Lösungsweg planen und umsetzen. Der Mensch gibt Ziel und Rahmen vor und beurteilt das Ergebnis. Darin liegt der Rollenwechsel: Wer früher jede Änderung selbst geschrieben hat, legt heute zunehmend fest, unter welchen Bedingungen ein Agent arbeiten darf und woran seine Arbeit gemessen wird.
Konkret heißt das: Der Mensch beschreibt das Ziel und die Kriterien für ein gutes Ergebnis. Er legt fest, auf welche Systeme und Daten der Agent zugreifen darf. Dazu kommen Grenzen für Laufzeit und Kosten sowie eine Regel dafür, wann der Agent abbrechen oder Hilfe anfordern muss.
Ebenso wichtig sind Freigaben an den richtigen Stellen. Welche Änderungen darf der Agent selbstständig vorbereiten und vor welcher Handlung muss ein Mensch zustimmen? Für diese Entscheidung muss nachvollziehbar sein, welche Schritte der Agent ausgeführt, welche Werkzeuge er genutzt und welche Ergebnisse er geprüft hat. Eine Freigabe ohne diese Informationen wäre kaum mehr als eine Formalie.
Arbeiten mehrere Agenten an einer Aufgabe, kommt eine weitere Frage hinzu: Wer darf welche Teilaufgabe weitergeben, und wie werden die Ergebnisse zusammengeführt? Auch für widersprüchliche Ergebnisse oder festgefahrene Abläufe braucht es eine klare Zuständigkeit.
Dieses Gestalten und Steuern des gesamten Ablaufs heißt Orchestrierung. Der Mensch muss dabei nicht jede Übergabe zwischen Agenten selbst auslösen. Er legt die Regeln fest, überwacht den Ablauf und greift ein, wenn eine Entscheidung oder Ausnahme es erfordert. Seine Arbeit verschiebt sich damit von der einzelnen Umsetzung hin zur stärkeren Steuerung und Prüfung des gesamten Ablaufs.
Wie viel darf der Agent allein?
Kontrollpunkte lassen sich verschieben
Ein Mensch kann vor dem Start den Plan prüfen, während der Umsetzung über offene Fragen entscheiden oder am Ende das Ergebnis freigeben. Welche Kontrollpunkte nötig sind, hängt von der Aufgabe, den möglichen Folgen eines Fehlers und den verfügbaren Prüfungen ab.
Eine kleine Codeänderung kann ein Agent beispielsweise in einer isolierten Entwicklungsumgebung selbstständig vorbereiten und testen. Dafür muss nicht jeder Zwischenschritt bestätigt werden. Ob die Änderung anschließend übernommen und produktiv eingesetzt werden darf, ist eine eigene Entscheidung.
Bei einer Änderung am Bezahlsystem können dagegen schon vor der Umsetzung Entscheidungen nötig sein, etwa wenn sich die Buchungslogik oder der Umgang mit Zahlungsdaten verändert. Eine zusätzliche Freigabe vor der Bereitstellung erfüllt einen anderen Zweck: Sie prüft, ob die konkrete Änderung die vereinbarten Anforderungen erfüllt. Kontrollpunkte gehören also dorthin, wo eine Entscheidung Folgen hat, die sich später nur schwer korrigieren lassen.
Muss der Mensch an festgelegten Punkten entscheiden, bevor der Ablauf weitergeht, spricht man von Human-in-the-Loop. Überwacht er den Ablauf und greift bei Bedarf ein, heißt das Human-on-the-Loop. Diese Formen lassen sich kombinieren: Ein Agent kann selbstständig arbeiten und dennoch vor einer besonders folgenreichen Handlung auf Zustimmung warten.
Kontrolle setzt voraus, dass der Mensch informiert entscheiden und wirksam eingreifen kann. Er braucht dafür Fachwissen, nachvollziehbare Ergebnisse und genügend Zeit. Bei einer laufenden Überwachung muss er außerdem erkennen können, wann ein Eingriff nötig ist, und den Ablauf rechtzeitig stoppen können.
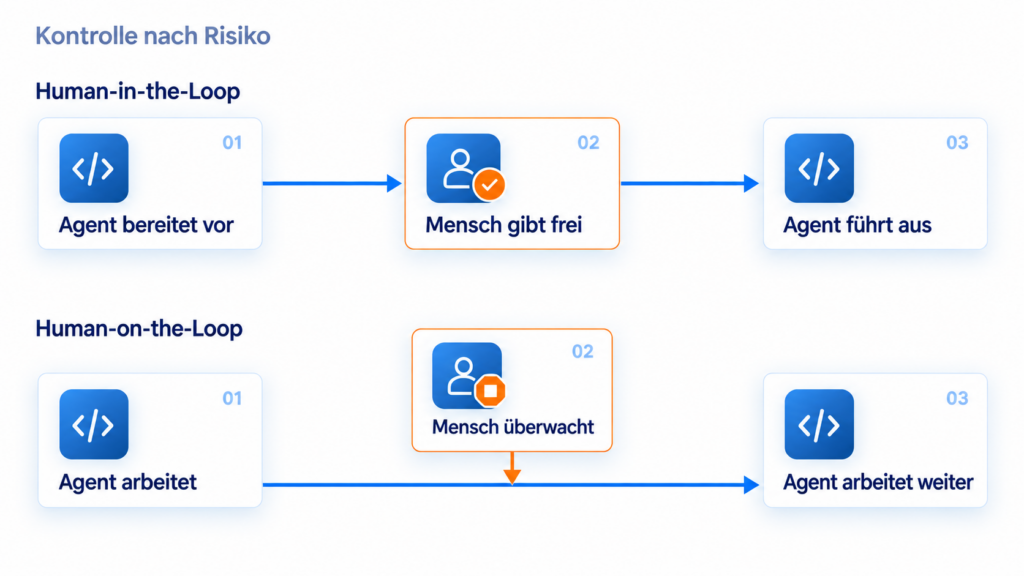
Bild wurde mit Hilfe von AI generiert
Wenn Agenten Stunden oder Tage arbeiten
Bei längeren Aufgaben reicht es nicht, einen Agenten zu starten und später nach dem Ergebnis zu sehen. Der Arbeitsstand muss so festgehalten werden, dass der Agent nach einer Unterbrechung oder einem Wechsel des Kontextfensters weiterarbeiten kann (vgl. Young, Justin, 2025). Dazu gehören abgeschlossene Schritte, offene Probleme, Testergebnisse und die nächste Teilaufgabe. Gespeicherte Notizen allein garantieren allerdings noch keinen zuverlässigen Fortschritt.
Wie zusätzliche Prüfungen aussehen können, zeigt ein Experiment von Anthropic zur Frontend-Gestaltung: Ein Agent erstellte die Oberfläche, ein zweiter bewertete sie anhand vorgegebener Kriterien. Die Versuche umfassten fünf bis fünfzehn Durchläufe und dauerten teilweise bis zu vier Stunden (vgl. Rajasekaran, Prithvi, 2026). Die getrennte Bewertung sollte unter anderem der Tendenz entgegenwirken, die eigene Arbeit zu positiv einzuschätzen. Auch der Prüfagent musste dafür gezielt abgestimmt werden.
Längere Laufzeit ist kein Qualitätsmerkmal. Entscheidend ist, ob der Agent überprüfbare Fortschritte macht. Wiederholt er erfolglose Versuche, überschreitet er sein Budget oder stößt er auf eine ungeklärte Anforderung, muss der Ablauf pausieren oder enden.
Zwischenprüfungen sollten deshalb konkrete Fragen beantworten: Was ist seit dem letzten Prüfpunkt fertig geworden? Welche Tests wurden bestanden? Was bleibt ungelöst? So erhält der Mensch eine Entscheidungsgrundlage, statt nur die Meldung, dass der Agent noch arbeitet.
Die Verantwortung bleibt beim Menschen
Mehr Autonomie verändert, wann Menschen eingreifen müssen. Sie hebt die Verantwortung für den Einsatz des Systems nicht auf. Dabei muss nicht eine einzelne Person alles übernehmen. Die Zuständigkeiten dürfen verteilt sein, aber sie müssen eindeutig bleiben.
Vor dem Start sollte feststehen, wer den laufenden Einsatz überwacht, wer bei Problemen entscheiden darf und wer das Ergebnis für die weitere Verwendung freigibt. Dazu gehört auch eine Vertretung, wenn die zuständige Person nicht erreichbar ist. Fehlt eine notwendige Entscheidung, muss der Agent warten, statt eigenständig seinen Handlungsspielraum zu erweitern.
Bei mehreren Agenten müssen diese Regeln für den gesamten Ablauf gelten. Eine Aufgabe darf nicht allein dadurch zusätzliche Befugnisse erhalten, dass sie an einen anderen Agenten weitergegeben wird. Damit rückt die nächste Frage in den Mittelpunkt: Wie lassen sich solche Übergaben zuverlässig gestalten?
Wenn Agenten mit Agenten arbeiten
Wenn ein Agent eine Teilaufgabe an einen anderen übergibt, reicht ein knapper Auftrag wie „Prüfe die Änderung“ nicht aus. Bei der Terminbuchung muss der prüfende Agent wissen, welches Verhalten erwartet wird, was geändert wurde und welche Tests bereits gelaufen sind. Ebenso wichtig ist, welche Fragen noch offen sind.
Eine gute Übergabe macht die Arbeit des ersten Agenten für den zweiten überprüfbar. Dazu gehören der relevante Arbeitsstand, die Anforderungen und die bisherigen Ergebnisse. Der prüfende Agent sollte sich nicht allein auf die Zusammenfassung seines Vorgängers verlassen, sondern die Änderung und die zugehörigen Tests selbst untersuchen können.
Auch der Rückweg muss geregelt sein. Findet der Prüfagent einen Fehler, braucht der umsetzende Agent eine konkrete Beschreibung: Was funktioniert nicht, unter welchen Bedingungen tritt das Problem auf und welches Verhalten wäre richtig? Kommen beide zu widersprüchlichen Ergebnissen oder wiederholt sich dieselbe Korrektur ohne Fortschritt, muss die Abstimmung enden und eine zuständige Person entscheiden.
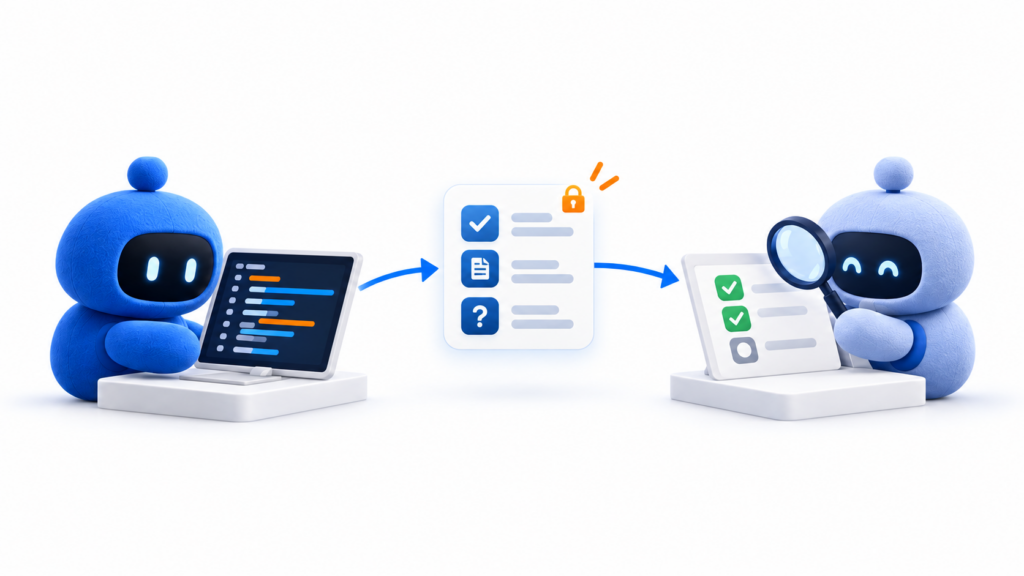
Bild wurde mit Hilfe von AI generiert
Innerhalb eines Systems lassen sich solche Übergaben beispielsweise über gemeinsam genutzte Dateien oder strukturierte Nachrichten organisieren. Schwieriger wird es, wenn Agenten unterschiedlicher Anbieter oder Plattformen zusammenarbeiten sollen. Dann brauchen sie eine gemeinsame Form, um Aufgaben, Bearbeitungsstände und Ergebnisse auszutauschen.
Dafür gibt es das offene Agent-to-Agent-Protokoll, kurz A2A. Es wurde von Google angestoßen und wird heute unter dem Dach der Linux Foundation weiterentwickelt. Nach deren Angaben unterstützten im April 2026 mehr als 150 Organisationen den Standard (vgl. Linux Foundation, 2026). A2A soll die Zusammenarbeit über Systemgrenzen hinweg ermöglichen. Nicht jedes Multi-Agent-System benötigt dafür ein solches Protokoll. Innerhalb einer einzelnen Anwendung können einfachere Übergaben ausreichen.
Ein gemeinsames Protokoll ersetzt jedoch keine Berechtigungsregeln. Darf ein Agent weitere Agenten beauftragen, muss feststehen, welche Befugnisse er dabei weitergeben darf. Der beauftragte Agent sollte nur die Zugriffe erhalten, die seine Teilaufgabe erfordert. Außerdem muss nachvollziehbar bleiben, wer den Auftrag ausgelöst hat und in wessen Auftrag gehandelt wird. Solche begrenzten und nachvollziehbaren Delegationen behandelt auch Forresters AEGIS-Framework zur Absicherung agentischer Systeme (vgl. Forrester, o. D.).
Damit wird die Zusammenarbeit der Agenten auch zu einer organisatorischen Aufgabe: Das Entwicklerteam muss nicht nur einzelne Ergebnisse prüfen, sondern ebenso die Übergaben und das Zusammenspiel der beteiligten Systeme gestalten.
Wie sich die Arbeit im Entwicklerteam verändert
Wenn Agenten Teile der Umsetzung übernehmen, muss das Team seine Aufgaben neu verteilen. Dabei helfen vier Fragen: Was übernimmt der Agent, wer pflegt seine Arbeitsumgebung, wer prüft und gibt frei, und welche Fähigkeiten brauchen Entwickler dafür?
Welche Aufgaben übernimmt der Agent?
Gut geeignet sind Aufgaben mit klarem Ziel, einem überprüfbaren Ergebnis und überschaubarem Risiko. Dazu gehören etwa abgegrenzte Fehlerkorrekturen oder das Ergänzen von Tests. Wo Anforderungen unklar sind oder Fehler weitreichende Folgen haben können, braucht es engere menschliche Begleitung. Entscheidend ist nicht nur, ob der Agent eine Lösung erstellen kann, sondern ob das Team sie zuverlässig beurteilen kann.
Wer hält die Arbeitsumgebung aktuell?
Ein Agent braucht verständliches Projektwissen, funktionierende Tests und passende Werkzeugzugriffe. Der technische Rahmen, der seine Ausführung, seinen Kontext und seine Werkzeuge steuert, wird häufig als Harness bezeichnet. Seine Pflege ist keine einmalige Einrichtung: Ändern sich Code, Anforderungen oder Werkzeuge, muss das Team auch diesen Rahmen überprüfen und anpassen (vgl. Young, 2025).
Wer prüft, wer gibt frei?
Wenn Agenten schneller Änderungen liefern, kann die Prüfung zum Engpass werden. Das Team braucht deshalb klare Zuständigkeiten und nachvollziehbare Ergebnisse: Was wurde geändert, welche Tests wurden ausgeführt und was bleibt offen? Ein überzeugend aussehendes Ergebnis ist noch kein richtiges. Technisches und fachliches Wissen bleiben nötig, um zu entscheiden, ob eine Änderung übernommen und eingesetzt werden darf.
Was müssen Entwickler künftig können?
Wer Umsetzung delegiert, muss Aufgaben klar beschreiben, Zusammenhänge verstehen und Ergebnisse kritisch prüfen können. Dafür bleiben Kenntnisse in Programmierung, Architektur, Tests und Betrieb wichtig. Sie helfen einzuschätzen, ob ein Lösungsansatz zum System passt und welche Folgen eine Änderung haben kann.
Das verändert auch die Ausbildung des Nachwuchses. Wenn Agenten Routineaufgaben übernehmen, brauchen Berufseinsteiger weiterhin Gelegenheiten, selbst zu programmieren, Fehler zu untersuchen und Lösungswege zu vergleichen. Gemeinsame Codeprüfungen und die Begleitung durch erfahrene Kollegen können diesen Lernprozess unterstützen.
Der Unterschied liegt nicht allein im Werkzeug, sondern darin, wie das Team damit arbeitet. Klare Aufgaben, eine gepflegte Arbeitsumgebung und fundierte Prüfungen machen aus einzelnen Agentenläufen einen verlässlicheren Entwicklungsprozess.
Bild wurde mit Hilfe von AI generiert
Fazit: Umsetzung delegieren, Verantwortung behalten
Wird der Entwickler überflüssig? Nein. Wenn Agenten Teile der Umsetzung übernehmen, verlagert sich sein Beitrag: Aufgaben klar beschreiben, technische Entscheidungen beurteilen und prüfen, ob eine Lösung die Anforderungen erfüllt. Weniger Code selbst zu schreiben bedeutet nicht, weniger vom System verstehen zu müssen.
Dafür braucht es klare Zuständigkeiten. CSG-CIO Joe Wilson betont sinngemäß, dass geteilte Verantwortung einen eindeutig benannten Verantwortlichen nicht ersetzt (vgl. Brans, Pat, 2026). Für das Team heißt das: Vor dem Einsatz muss feststehen, wer den Ablauf überwacht, bei Problemen entscheidet und das Ergebnis freigibt.
Ein sinnvoller Einstieg beginnt deshalb mit einer überschaubaren Aufgabe. Ziel, Prüfkriterien und Grenzen stehen vorher fest. Erst wenn der Ablauf zuverlässig funktioniert, erhält der Agent mehr Spielraum. Zusätzliche Agenten kommen dort hinzu, wo die Arbeitsteilung einen erkennbaren Nutzen bringt.
Agentic Engineering heißt nicht, die Entwicklung sich selbst zu überlassen. Es heißt, die Umsetzung gezielt zu delegieren und die Verantwortung dafür wahrzunehmen.
Mit CubeServ ins Gespräch kommen
Beim Einstieg in AI und bei konkreten Vorhaben unterstützen wir Sie:
- Trainings und Workshops: Grundlagen, Prompting sowie AI-Workflows und Agenten, vom Einstieg bis zur Vertiefung: CubeServ Academy
- Strategie und Anwendungsfälle: Geeignete Einsatzmöglichkeiten identifizieren, bewerten und die nächsten Schritte planen: AI Excellence
- Sicherheit und Governance: AI-Systeme verantwortungsvoll gestalten und ihre Risiken und Zugriffe berücksichtigen: AI Transformation
- Entwicklung und Umsetzung: Individuelle AI-Anwendungen und Agenten entwickeln und Projekte bis zum produktiven Einsatz begleiten: AI Transformation
Lassen Sie uns ins Gespräch kommen. Gemeinsam finden wir heraus, welcher nächste Schritt für Ihr Team sinnvoll ist.
Quellenverzeichnis
- Brans, Pat. (2026). 5 Wege zu mehr KI-Accountability. Computerwoche. https://www.computerwoche.de/article/4194451/5-wege-zu-mehr-ki-accountability.html
- Forrester. (o. D.). The AEGIS Framework: Enterprise Guardrails For Securing Agentic AI. Abgerufen am 5. Oktober 2026, von https://www.forrester.com/technology/aegis-framework/
- Linux Foundation. (2026). A2A Protocol Surpasses 150 Organizations, Lands in Major Cloud Platforms, and Sees Enterprise Production Use in First Year. https://www.linuxfoundation.org/press/a2a-protocol-surpasses-150-organizations-lands-in-major-cloud-platforms-and-sees-enterprise-production-use-in-first-year
- Rajasekaran, Prithvi. (2026). Harness design for long-running application development. Anthropic. https://www.anthropic.com/engineering/harness-design-long-running-apps
- Young, Justin. (2025). Effective harnesses for long-running agents. Anthropic. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
Dieser Beitrag wurde mit Unterstützung generativer KI erstellt und redaktionell geprüft.