

Bild wurde mit Hilfe von AI generiert
Was passiert, wenn die AI über Nacht arbeitet?
Die Szene, mit der Teil 1 unserer Blogserie begann, ist schnell erzählt: Ein Agent arbeitet über Nacht an einer Aufgabe. Am nächsten Morgen meldet er „fertig“, eine Änderung wartet auf Freigabe. Auf den ersten Blick scheint die Arbeit erledigt.
Was dabei leicht aus dem Blick gerät: Jemand musste vorher das Ziel beschreiben und die Grenzen festlegen. Nun muss jemand prüfen, ob die Änderung fachlich richtig ist, zum bestehenden System passt und die Anforderungen erfüllt. Die Meldung „fertig“ ersetzt diese Prüfung nicht.
Genau darum geht es in diesem Teil: wie sich der Arbeitsalltag von Entwicklern verändert, wenn Agenten die Umsetzung übernehmen. Aufträge formulieren, Pläne beurteilen, Rückfragen klären und Ergebnisse prüfen – all das wird wichtiger. Der Agent übernimmt mehr Arbeit, die Verantwortung bleibt beim Entwicklerteam.
Die eigentliche Arbeit beginnt vor dem Code
Um zu verstehen, wo Agenten entlasten können, lohnt sich ein Blick auf die gesamte Entwicklungsarbeit: das Problem verstehen, Lösungswege suchen, Ansätze bewerten, ausprobieren, Code schreiben, testen und Fehler beheben. Das Schreiben des Codes ist nur ein Teil davon.
Eine Antwort auf Stack Overflow oder ein Beispiel aus der Dokumentation ist noch keine passende Lösung. Entscheidend ist, ob der Ansatz die Anforderungen erfüllt, zum bestehenden System passt und sich langfristig warten lässt. Auch eine bewährte Vorgehensweise eignet sich nicht automatisch für jedes Projekt.
Erst beim Ausprobieren zeigt sich, ob eine Idee trägt. Dafür müssen Entwickler einen Ansatz aufbauen, ausführen und das Ergebnis prüfen. Manches funktioniert technisch, löst aber nicht das eigentliche Problem. Dazu kommt die Fehlersuche: Manchmal ist die Ursache in wenigen Minuten gefunden, manchmal dauert schon das Eingrenzen mehrere Stunden.
Stellt sich dabei heraus, dass der gesamte Lösungsansatz nicht trägt, beginnt die Suche erneut. Eine Alternative muss gefunden, bewertet und erprobt werden. Der verworfene Versuch liefert zwar Erkenntnisse, hat aber Zeit gekostet. Im fertigen Code ist dieser Aufwand kaum sichtbar.
Genau beim Suchen, Ausprobieren und Prüfen können AI-Agenten entlasten. Sie können Lösungswege recherchieren, Varianten umsetzen, Tests ausführen und anhand der Ergebnisse nachbessern. Der Entwickler muss dadurch nicht jeden Versuch selbst aufbauen. Er muss aber weiterhin beurteilen, ob die vorgeschlagene Lösung tatsächlich zum eigenen System passt.
Dieselbe Arbeit, andere Handgriffe
Wer regelmäßig mit AI-Agenten arbeitet, setzt im Entwicklungsalltag andere Schwerpunkte. Ein Arbeitstag kann damit beginnen, die Ergebnisse eines nächtlichen Agentenlaufs zu prüfen. Dazu kommen neue Aufträge und die Abstimmung von Plänen und Rückfragen während der Umsetzung. Statt jede Änderung selbst zu schreiben, liest der Entwickler den entstandenen Code, bewertet Testergebnisse und steuert nach, wenn etwas nicht passt.
Suchen, Bewerten und Ausprobieren – all das erledigt sich dadurch nicht. Der Agent übernimmt einen Teil dieser Arbeit, der Entwickler hinterfragt die Ergebnisse. Entscheidend ist nicht nur, ob eine Lösung funktioniert, sondern ob ihre Annahmen stimmen und sie zum bestehenden System passt. Dafür bleibt technisches Verständnis unverzichtbar. Ob diese Arbeitsteilung tatsächlich Zeit spart, hängt auch davon ab, wie viel Anleitung, Prüfung und Nacharbeit nötig bleibt.
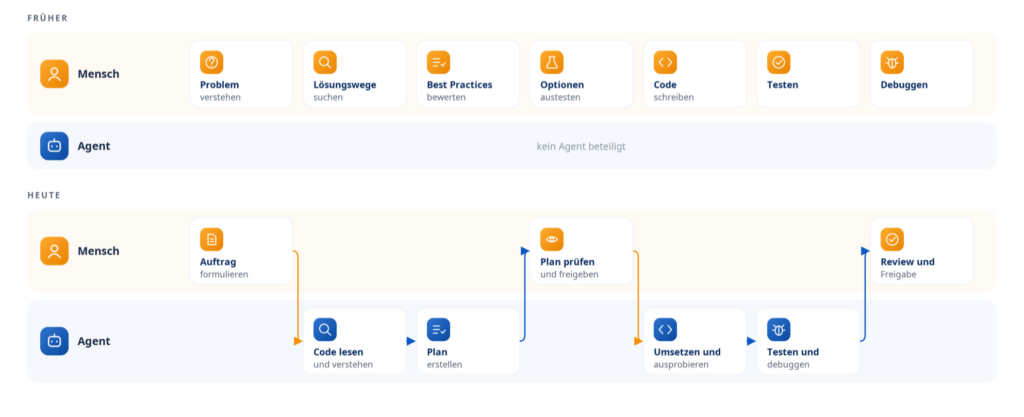
Bild wurde mit Hilfe von AI generiert
Auch Andrej Karpathy betont, dass Entwickler die Grundlagen ihrer Systeme weiterhin verstehen müssen. Er unterscheidet drei Ansätze: Verhalten durch klassischen Code festlegen (Software 1.0), durch das Training neuronaler Netze erlernen lassen (Software 2.0) und Sprachmodelle über Prompts und Kontext steuern (Software 3.0). Diese Ansätze ergänzen sich, statt einander vollständig zu ersetzen. Für die Arbeit mit Coding-Agenten heißt das: Entwickler müssen nicht jedes Detail einer Schnittstelle auswendig kennen. Sie müssen aber erkennen können, welche Annahmen hinter einer Lösung stehen und welche Folgen eine Änderung für das System hat (vgl. Andrej Karpathy, 2026).
Die Aufgaben bleiben ähnlich, ihre Gewichtung verändert sich:
Klassische Entwicklung | Agentengestützte Entwicklung | |
|---|---|---|
Schwerpunkt der Arbeit | Lösungen selbst implementieren und prüfen | Aufgaben strukturieren, Umsetzung delegieren und prüfen |
Technisches Können | Systeme verstehen und Lösungen umsetzen | Systeme verstehen und Agentenergebnisse beurteilen |
Qualitätssicherung | Tests, Code-Review und funktionale Prüfung | Dieselben Maßstäbe, zusätzlich Annahmen und Änderungen des Agenten hinterfragen |
Wenn „fertig" nicht gleich fertig ist
Wenn ein Agent wiederholt lauffähigen Code und grüne Tests liefert, wächst das Vertrauen. Das kann dazu verleiten, Änderungen schneller zu übernehmen und weniger genau hinzusehen. Doch ein bestandener Test bestätigt nur das, was er tatsächlich prüft. Ob die Lösung auf den richtigen Annahmen beruht, ist damit noch nicht geklärt.
Andrej Karpathy beschreibt das am Beispiel seiner Anwendung MenuGen: Ein Agent wollte ein gekauftes Guthaben anhand der E-Mail-Adresse beim Zahlungsanbieter Stripe dem passenden Google-Konto zuordnen. Der Ansatz wirkte plausibel. Nutzer können für die Zahlung allerdings eine andere E-Mail-Adresse verwenden als für die Anmeldung. Dann erreicht das Guthaben möglicherweise nicht das richtige Konto. Die Zuordnung braucht deshalb eine stabile Nutzer-ID, die den Kauf eindeutig mit dem Nutzerkonto verbindet (vgl. Andrej Karpathy, 2026).
Der Fehler lag im Entwurf, nicht in der Syntax. Ein Test mit identischen E-Mail-Adressen für Zahlung und Anmeldung würde den problematischen Fall nicht abdecken. Dafür müsste gezielt mit unterschiedlichen Adressen geprüft werden. Welche Fälle wichtig sind, ergibt sich aus den Anforderungen und Regeln des Produkts, nicht allein aus dem erzeugten Code. Der Agent kann Tests schreiben und ausführen. Das Entwicklerteam bleibt dafür verantwortlich, ihre Aussagekraft zu beurteilen und das Ergebnis zu prüfen.
So führt man einen Agenten
Wirksame Kontrolle bedeutet nicht, jeden Schritt des Agenten zu begleiten. Entscheidend ist, vor der Umsetzung die Richtung abzustimmen, bei Problemen einzugreifen und anschließend das Ergebnis zu prüfen. Dafür hilft ein Ablauf aus vier Phasen: Explore, Plan, Implement und Review, also Verstehen, Planen, Umsetzen und Prüfen. Auch Anthropic empfiehlt, Erkundung und Planung von der Umsetzung zu trennen und dem Agenten Möglichkeiten zur Ergebnisprüfung zu geben (vgl. Anthropic, o. J.).
Erst verstehen. Dann bauen
Zunächst untersucht der Agent den Code, die Schnittstellen und die vorhandenen Tests, die für seine Aufgabe relevant sind. Welche Funktionen gibt es bereits? Welche Regeln gelten? Wo würde die Änderung eingreifen? Am Anwendungscode wird dabei noch nichts verändert. Ziel ist nicht, das gesamte Projekt einzulesen, sondern die Aufgabe im bestehenden System zu verstehen. Fehlen entscheidende Informationen, sollte der Agent nachfragen, statt die Lücken stillschweigend mit Annahmen zu füllen.
Der Plan gibt die Richtung vor
Lassen Sie den Agenten vor größeren Änderungen erklären, wie er vorgehen will. Ein Auftrag kann lauten:
Erkläre mir deinen Lösungsansatz, welche Dateien du ändern möchtest und wie du das Ergebnis prüfen wirst. Benenne offene Fragen. Noch nichts umsetzen.
Ein geprüfter Plan hilft, eine falsche Richtung zu erkennen, bevor daraus umfangreiche Änderungen entstehen. Entscheidend ist, dass der Plan verständlich macht, was geändert werden soll und warum.
Claude Code unterstützt diese Trennung mit dem Plan Mode. In der Terminaloberfläche wechseln Sie mit Shift+Tab durch die verfügbaren Modi, bis er angezeigt wird. Der Agent kann dann den Code untersuchen und einen Umsetzungsplan erstellen, ohne den Anwendungscode zu verändern (vgl. Anthropic, o. J.).
Auch Boris Cherny, der Claude Code entwickelt hat, beschreibt diesen Ablauf: Er beginnt die meisten seiner Sessions im Plan Mode, stimmt den Plan mit dem Agenten ab und wechselt erst danach zur Umsetzung (vgl. Boris Cherny, 2026).
Bei der Prüfung helfen drei Fragen: Hat der Agent das Ziel richtig verstanden? Sind die Änderungen auf das Notwendige begrenzt? Prüfen die vorgesehenen Tests die Anforderungen? Unbegründet viele Änderungen, fehlende Prüfschritte oder unklare Annahmen sind Gründe, den Plan zunächst überarbeiten zu lassen.
Den Agenten arbeiten lassen
Nach der Freigabe setzt der Agent den Plan innerhalb des vereinbarten Rahmens um. Er liest bei Bedarf weiteren Code, nimmt Änderungen vor und führt Prüfungen aus. Schlägt ein Test fehl, wertet er die Rückmeldung aus, korrigiert seine Lösung und prüft erneut. Dieses Umsetzen, Prüfen und Korrigieren bildet die interne Rückschleife des Agenten.
Nicht jeder Durchlauf braucht einen menschlichen Eingriff. Der Auftrag sollte deshalb nicht nebenbei durch immer neue Wünsche verändert werden. Fehlt eine fachliche Entscheidung, weicht der Agent deutlich vom Plan ab oder wiederholt er erfolglose Versuche, ist eine Unterbrechung sinnvoll. Dann werden Ursache und weiteres Vorgehen geklärt. Ändern sich Ziel oder Umfang der Aufgabe, muss auch der Plan angepasst werden.
Das Ergebnis prüfen
Nach dem Lauf braucht das Ergebnis drei getrennte Prüfungen:
- Tests: Wurden sie tatsächlich ausgeführt? Decken sie die Anforderungen und wichtige Fehlerfälle ab, oder bestätigen sie lediglich das Verhalten des erzeugten Codes?
- Änderungen: Lesen Sie den Code wie den Pull Request eines Kollegen. Sind die Lösung und ihre Annahmen nachvollziehbar? Wurde nur geändert, was zur Aufgabe gehört?
- Funktion: Prüfen Sie das Verhalten in einer geeigneten Testumgebung. Funktioniert die Änderung auch im vorgesehenen Ablauf und nicht nur im isolierten Test?
Zeigt das Review Mängel, erhält der Agent konkretes Feedback für die Nacharbeit. Liegt der Fehler bereits im Lösungsansatz, wird zuerst der Plan überarbeitet oder das Verständnis der Aufgabe geklärt. Danach folgt eine erneute Prüfung. Das ist die Rückschleife im übergeordneten Arbeitsablauf: menschliches Review, gezielte Korrektur und erneute Bewertung.
Davon zu unterscheiden ist die Selbstprüfung während der Umsetzung. Cherny nennt überprüfbare Rückmeldungen einen der wichtigsten Hebel für bessere Ergebnisse. Mit Zugriff auf eine Testsuite oder einen Browser kann der Agent Fehler selbst erkennen und seine Arbeit überarbeiten, bevor sie beim Menschen landet. Das kann den Prüfaufwand reduzieren, ersetzt aber nicht das menschliche Review (vgl. Boris Cherny, 2026).
Wie tief geprüft werden muss, hängt vom Risiko ab. Änderungen an Berechtigungen, Kundendaten oder Zahlungen verlangen besondere Sorgfalt. Ein isolierter Prototyp ohne sensible Daten kann dagegen mit weniger Prüfaufwand auskommen.
Die letzte Entscheidung bleibt beim Menschen
Diese Arbeitsteilung folgt dem Prinzip Human-in-the-Loop: Der Mensch entscheidet an relevanten Stellen mit, etwa bei der Freigabe des Plans, bei offenen Fragen während der Umsetzung und vor der Übernahme des Ergebnisses. Er muss nicht jeden technischen Schritt begleiten, aber den Ablauf unterbrechen und korrigieren können. Ziel, Grenzen und Verantwortung bleiben beim Menschen.
Damit diese Kontrolle wirksam bleibt, müssen die Aufträge überschaubar und ihre Ergebnisse überprüfbar sein. Größere Vorhaben werden deshalb in Arbeitsschritte zerlegt, deren Plan und Änderungen sich sinnvoll beurteilen lassen. Ein Auftrag ist nicht ausreichend kontrolliert, nur weil jemand einen langen Plan formal bestätigt hat.
Bei einer kleinen, risikoarmen Änderung, etwa einem Tippfehler in einem Hilfetext, kann ein eigener Planungsschritt entfallen. Entscheidend ist die Tragweite: Je größer die Auswirkungen einer Änderung, desto wichtiger sind ein geprüfter Plan und ein sorgfältiges Review.
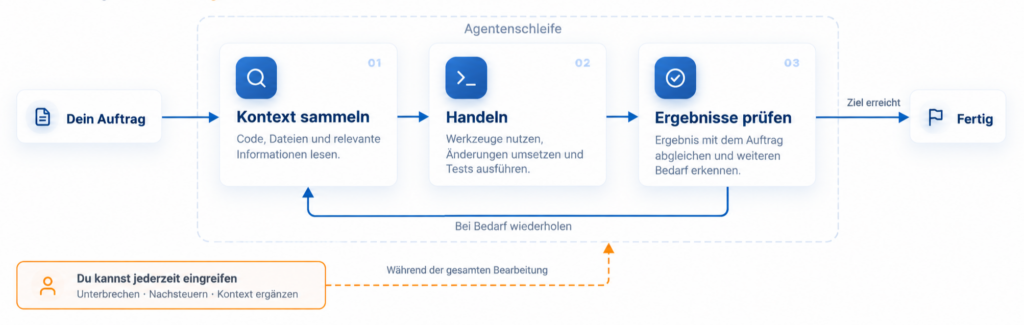
Bild wurde mit Hilfe von AI generiert
Produktivität auf dem Prüfstand
Agenten können beim Suchen, Ausprobieren und Debuggen entlasten. Gleichzeitig kosten Anleitung, Prüfung und Nacharbeit Zeit. Ob ein Agent Zeit spart, zeigt sich deshalb erst am gesamten Weg bis zur geprüften Lösung.
Drei Feldexperimente mit 4.867 Entwicklern bei Microsoft, Accenture und einem weiteren Großunternehmen liefern einen Anhaltspunkt. Ihre gemeinsame Auswertung ergab rund 26 % mehr abgeschlossene Aufgaben mit GitHub Copilot. Untersucht wurde Code-Vervollständigung, kein autonomer Agent. Mehr erledigte Aufgaben bedeuten außerdem nicht automatisch entsprechend weniger Bearbeitungszeit (vgl. Cui et al., 2025).
Ein anderes Experiment stellte 95 Entwicklern dieselbe Aufgabe: einen HTTP-Server in JavaScript bauen. Unter den Teilnehmenden, die die Aufgabe abschlossen, benötigte die Copilot-Gruppe durchschnittlich 71 statt 161 Minuten, also 56 % weniger Zeit. Das ist ein deutlicher Vorteil bei einer klar abgegrenzten Einzelaufgabe, aber kein Beleg für denselben Zeitgewinn im Alltag eines Entwicklungsteams (vgl. Peng et al., 2023).
Dass AI-Unterstützung auch bremsen kann, zeigte die METR-Studie von 2025. Bei 16 erfahrenen Entwicklern und 246 Aufgaben in vertrauten Open-Source-Projekten dauerte die Bearbeitung mit AI im Mittel 19 % länger, obwohl sich die Teilnehmenden hinterher schneller einschätzten. Der Befund ist eine Momentaufnahme der damaligen Werkzeuge. Im Update vom Februar 2026 berichtet METR von Hinweisen auf Verbesserungen. Deren Ausmaß lässt sich wegen Auswahlverzerrungen und Schwierigkeiten bei der Zeitmessung jedoch nicht zuverlässig bestimmen (vgl. METR, 2025; METR, 2026).
Die Studien untersuchen unterschiedliche Aufgaben, Werkzeuge und Messgrößen. Sie liefern deshalb keine allgemeingültige Produktivitätszahl für heutige Coding-Agenten. Für Teams zählt, ob bei vergleichbarer Qualität insgesamt weniger Aufwand entsteht. Auch ein nächtlicher Agentenlauf muss sich daran messen lassen, wie viel Anleitung vorher und wie viel Prüfung und Nacharbeit danach nötig sind.
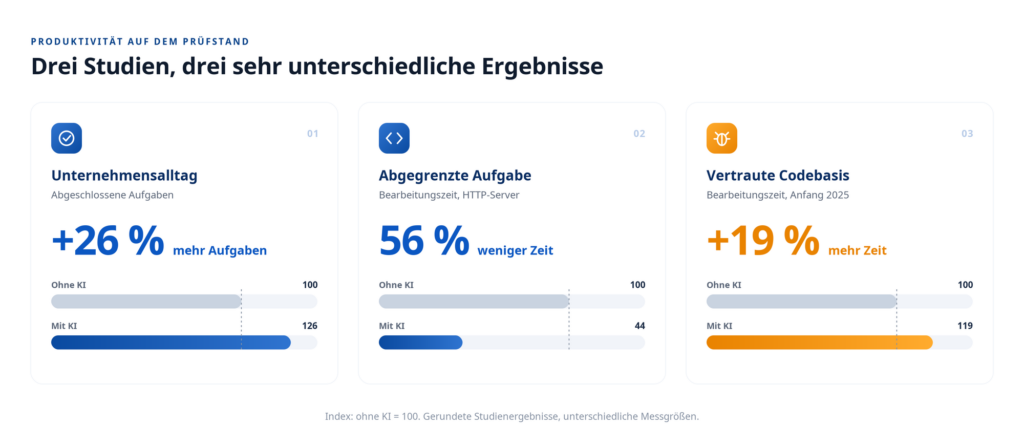
Bild wurde mit Hilfe von AI generiert
Fazit: Agenten beschleunigen, Menschen entscheiden
AI-Agenten können Entwicklungsarbeit beschleunigen. Entscheidend ist jedoch der gesamte Aufwand vom Auftrag bis zur geprüften Änderung, nicht allein das Tempo der Umsetzung. Schnell erzeugter Code ist noch keine fertige Lösung.
Der Entwickler legt das Ziel fest, beurteilt den vorgeschlagenen Plan und prüft das Ergebnis. Dazu gehört, die Annahmen hinter dem Code zu hinterfragen und zu erkennen, welche Fehler die Tests möglicherweise nicht abdecken. Wie bei der Arbeit eines Kollegen braucht es ein Review, bevor die Änderung übernommen wird.
Weniger Tippen bedeutet nicht weniger Verantwortung. Technisches Verständnis bleibt die Voraussetzung dafür, Aufgaben sinnvoll abzugeben und Ergebnisse beurteilen zu können.
Damit diese Zusammenarbeit nicht bei jeder Aufgabe von vorn beginnt, braucht der Agent ein verlässliches Arbeitsumfeld: aktuelles Projektwissen, klare Regeln, geeignete Werkzeuge und passende Berechtigungen. Wie dieses Setup entsteht und was einen Agenten im Alltag zuverlässig unterstützt, zeigt Teil 3.
Sie möchten AI-Agenten in Ihrer Softwareentwicklung erproben? Wir entwickeln mit Ihnen einen passenden Piloten.
Quellenverzeichnis
- Andrej Karpathy. (2026). Sequoia Ascent 2026 summary. karpathy.bearblog.dev. https://karpathy.bearblog.dev/sequoia-ascent-2026/
- Boris Cherny. (2026). Thread über seinen persönlichen Claude-Code-Workflow. X. Abgerufen am 29. August 2026, von https://x.com/bcherny/status/2007179832300581177
- Anthropic. (o. J.). Best practices for Claude Code. Claude Code Docs. https://code.claude.com/docs/en/best-practices
- Cui, Demirer, Jaffe, Musolff, Peng, Salz. (2025). The Effects of Generative AI on High-Skilled Work: Evidence from Three Field Experiments with Software Developers. Microsoft Research. https://www.microsoft.com/en-us/research/publication/the-effects-of-generative-ai-on-high-skilled-work-evidence-from-three-field-experiments-with-software-developers/
- Peng, Kalliamvakou, Cihon, Demirer. (2023). The Impact of AI on Developer Productivity: Evidence from GitHub Copilot. arXiv. https://arxiv.org/abs/2302.06590
- METR. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- METR. (2026). We are Changing our Developer Productivity Experiment Design. https://metr.org/blog/2026-02-24-uplift-update/
Dieser Beitrag wurde mit Unterstützung generativer KI erstellt und redaktionell geprüft.