

Bild wurde mit Hilfe von AI generiert
Warum gute Anweisungen allein nicht reichen
Wer einen Agenten so führt, wie in Teil 2 unserer Blogserie beschrieben, teilt die Arbeit in überschaubare Schritte auf, prüft die Ergebnisse und lässt Fehler korrigieren. Trotzdem kann die Qualität hinter den Erwartungen zurückbleiben.
Eine mögliche Ursache liegt im Arbeitsumfeld: Bei jeder neuen Aufgabe muss der Agent erst herausfinden, wie das Projekt aufgebaut ist. Er durchsucht lange Dokumentationen, obwohl nur wenige Abschnitte relevant sind. Wichtige Projektregeln fehlen in seinem Kontext. Welche Dateien er verändern darf und welche nicht, ist ebenfalls nicht festgelegt.
Ein guter Auftrag beschreibt das Ziel. Er ersetzt aber kein verlässliches Projektwissen. Aufbau, Regeln und Arbeitsweisen des Projekts sollten nicht bei jeder Aufgabe neu erklärt werden müssen. Der Agent braucht relevante Informationen in kompakter Form, Anweisungen für wiederkehrende Aufgaben, geeignete Werkzeuge und klar begrenzte Berechtigungen.
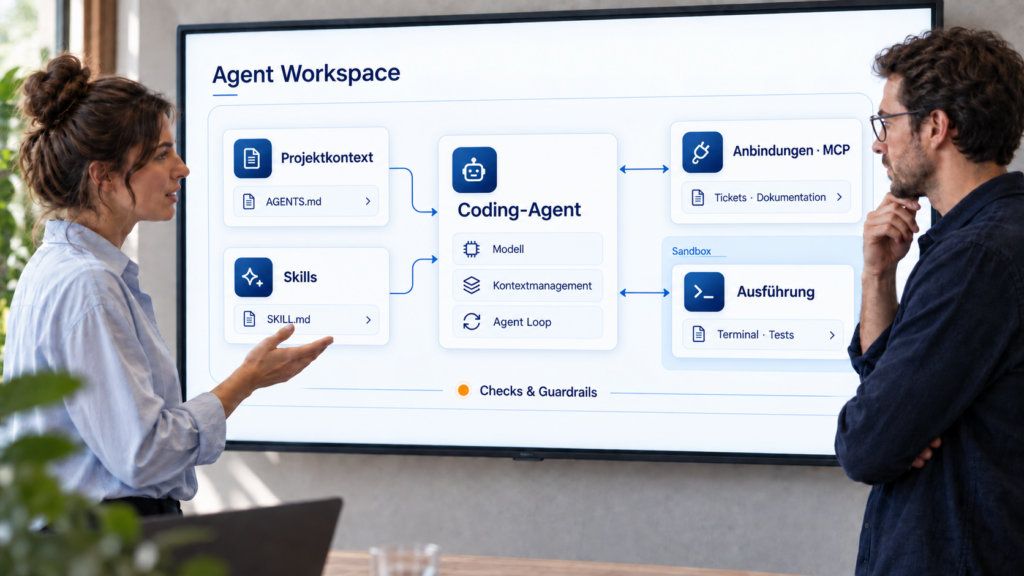
Dieses Setup heißt AI-Agent Harness: die Ausstattung rund um das Modell aus Projektwissen, Anweisungen, Werkzeugen und Berechtigungen, die den Agenten Aufträge zuverlässig bearbeiten lässt. Dazu kommen wir später hier im Text.
Das richtige Umfeld entscheidet
Beim Setup kommt es nicht darauf an, dem Agenten möglichst viele Informationen mitzugeben. Entscheidend ist, dass er die für seine Aufgabe relevanten Informationen erhält. Fehlen wichtige Angaben, sollte er nachfragen. Stehen sie zwischen umfangreichen, wenig hilfreichen Inhalten, kann er sie übersehen oder unzureichend berücksichtigen.
Sprachmodelle verarbeiten Informationen innerhalb eines begrenzten Kontextfensters. Darin stehen unter anderem die Anweisungen, der bisherige Gesprächsverlauf und die vom Agenten abgerufenen Inhalte. Lange Dokumentationen pauschal einzulesen, beansprucht diesen Platz, ohne zwangsläufig das Ergebnis zu verbessern. Sinnvoller ist es, grundlegende Projektregeln kompakt bereitzuhalten und weitere Informationen gezielt bei Bedarf abzurufen.
Das gilt auch für lange Sitzungen. Mit der Zeit sammeln sich überholte Zwischenergebnisse, Korrekturen und Nebenthemen an. Mehr Verlauf bedeutet nicht automatisch mehr hilfreichen Kontext. Wird die Sitzung unübersichtlich, kann ein Neustart sinnvoll sein. Dafür braucht der Agent eine aktuelle Zusammenfassung, die das Ziel, getroffene Entscheidungen, relevante Änderungen und offene Fragen festhält.
Ein gutes Setup verbindet deshalb vier Bausteine:
- Auftrag und Arbeitsstand: Was soll erreicht werden, was ist bereits erledigt und was bleibt offen?
- Projektwissen und Regeln: Wie ist das System aufgebaut, welche Konventionen gelten und welche Bereiche dürfen nicht verändert werden?
- Wiederverwendbare Anweisungen: Wie sollen wiederkehrende Aufgaben bearbeitet und ihre Ergebnisse geprüft werden?
- Werkzeuge und Berechtigungen: Welche Informationen und Funktionen kann der Agent nutzen, und welche Aktionen darf er ausführen?
Die gezielte Auswahl und Bereitstellung der Informationen im Kontext wird als Context Engineering bezeichnet. Dazu gehört auch, festzulegen, welche Inhalte der Agent wann über seine Werkzeuge abrufen kann. Es geht damit über einen gut formulierten Prompt hinaus. Das gesamte Setup umfasst zusätzlich die technische Einrichtung der Werkzeuge und die Durchsetzung von Zugriffsgrenzen.
Ein klarer Auftrag verhindert falsche Annahmen
„Bau eine Exportfunktion“ lässt viele Fragen offen: Was soll exportiert werden? Für wen? Welche Datenmengen sind zu erwarten? Und woran erkennt man, dass die Funktion fertig ist? Fehlen diese Angaben, sollte der Agent nachfragen. Setzt er die Aufgabe stattdessen auf Grundlage eigener Annahmen um, kann eine technisch funktionierende Lösung entstehen, die am Bedarf vorbeigeht.
Ein guter Auftrag macht das Ziel und die Bedingungen für ein akzeptables Ergebnis deutlich. Er beantwortet vier Fragen:
- Ziel: Was soll entstehen und für wen?
- Zusammenhang: In welchem Ablauf und unter welchen Bedingungen wird die Lösung eingesetzt?
- Grenzen: Was gehört zur Aufgabe und was ausdrücklich nicht?
- Abnahmekriterien: Woran lässt sich überprüfen, ob die Aufgabe erfüllt ist?
Für die Exportfunktion könnte ein solcher Auftrag lauten:
Erstelle einen CSV-Export für die Kundenliste, den Anwender über einen Button starten können. Exportiert werden alle Datensätze, die den aktuell gesetzten Filtern entsprechen, nicht nur die Einträge auf der angezeigten Seite. Bestehende Zugriffsrechte müssen auch beim Export gelten.
Die Liste kann bis zu 50.000 Einträge enthalten. Der Export muss diese Datenmenge verarbeiten können, ohne an einem Anfrage-Timeout zu scheitern. Zusätzliche Exportformate und Änderungen an der Filterlogik gehören nicht zur Aufgabe.
Die Aufgabe ist abgeschlossen, wenn ein Test mit 50.000 passenden Datensätzen in der vereinbarten Testumgebung erfolgreich ist. Prüfe außerdem, dass Filter und Zugriffsrechte berücksichtigt werden, keine Datensätze fehlen oder doppelt enthalten sind und die exportierten Spalten in Auswahl und Reihenfolge der Anzeige entsprechen. Kläre vor der Umsetzung, welche Testumgebung und Timeout-Grenzen gelten.
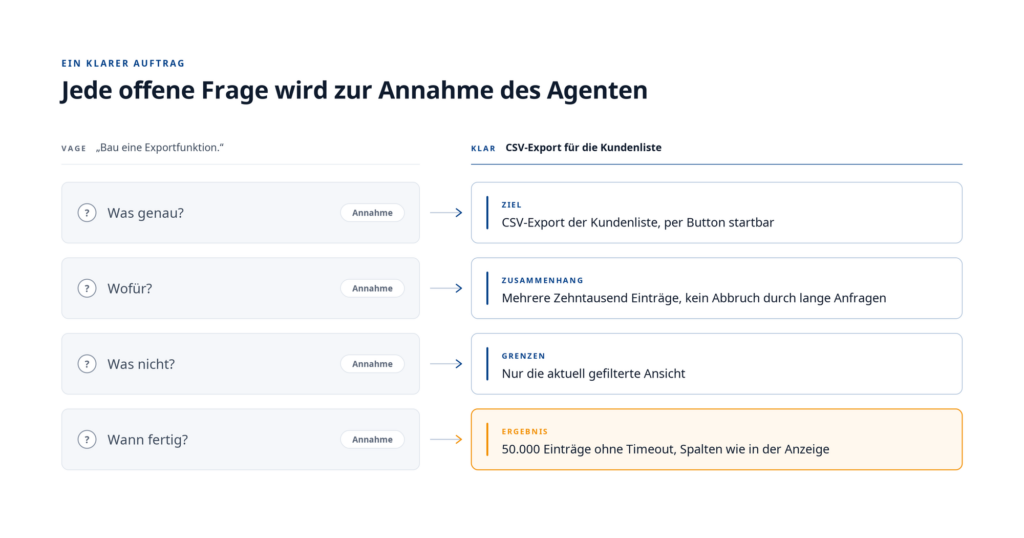
Bild wurde mit Hilfe von AI generiert
Entscheidend ist nicht die Länge des Auftrags, sondern seine Eindeutigkeit. Aufgabenspezifische Anforderungen gehören in den Auftrag, dauerhaft geltende Regeln ins Projektwissen. So muss nicht jedes Mal neu beschrieben werden, welche technischen Konventionen gelten oder welche Bereiche nicht verändert werden dürfen. Für die konkrete Aufgabe besonders wichtige Regeln können im Auftrag ausdrücklich hervorgehoben werden.
Das gezielte Formulieren solcher Anweisungen wird als Prompt Engineering bezeichnet. Es ist ein erlernbares Handwerk: Ziele verständlich beschreiben, relevante Bedingungen benennen und überprüfbare Ergebnisse vereinbaren. Der Prompt ist damit ein Baustein des zuvor beschriebenen Context Engineering.
Das Setup: Wissen, Anweisungen, Werkzeuge und Modellwahl
Ist der Auftrag geklärt, kommt es auf die Umgebung an, in der der Agent arbeitet. Projektwissen gibt ihm Orientierung. Wiederverwendbare Anweisungen beschreiben bewährte Abläufe. Werkzeuge ermöglichen ihm, Informationen abzurufen, Änderungen vorzunehmen und Ergebnisse zu prüfen. Dazu kommt die Wahl eines Modells, das zur Aufgabe passt. Diese Bausteine müssen zusammenpassen, damit aus einem klaren Auftrag ein brauchbares Ergebnis wird.
Das Gedächtnis: Einmal erklären statt immer wieder
Projektaufbau, Konventionen und Zuständigkeiten ändern sich nicht mit jeder Aufgabe. Trotzdem müssen sie immer wieder erklärt werden, wenn sie dem Agenten in einer neuen Sitzung nicht zur Verfügung stehen.
Ein praktischer Ausgangspunkt ist eine kurze Anweisungsdatei im Projekt, die das eingesetzte Werkzeug automatisch in den Kontext lädt. Vergleichbar ist sie mit dem Merkblatt, das ein neuer Kollege am ersten Arbeitstag bekommt: Es erklärt, wie hier gearbeitet wird und wo wichtige Informationen zu finden sind. Es ersetzt nicht die gesamte Projektdokumentation.
Für diese Datei gibt es mit AGENTS.md ein offenes Format, welches von mehreren Coding-Werkzeugen unterstützt wird. Claude Code verwendet dafür unter anderem CLAUDE.md. Welche Dateien tatsächlich geladen werden, hängt vom Werkzeug, seiner Version und der Konfiguration ab. Prüfen Sie deshalb bei der Einrichtung, ob die vorgesehenen Anweisungen beim Agenten ankommen (vgl. AGENTS.md, o. J.; Anthropic, o. J.-a).
Als Einstieg reichen vier Themenblöcke:
- Projekt und Orientierung: Was macht das System, wie ist es grob aufgebaut und wo stehen weiterführende Informationen?
- Arbeitsweise: Wie wird das Projekt gebaut und getestet? Welche Prüfungen sind vor der Übergabe erforderlich?
- Konventionen: Welche technischen und fachlichen Regeln gelten, die sich nicht ohne Weiteres aus dem Code ergeben?
- Grenzen: Welche Bereiche sollen unverändert bleiben und welche Änderungen erfordern eine Rückfrage oder Freigabe?
Technische Angaben sind dabei nicht grundsätzlich Ballast. Ein benötigter Testbefehl oder eine ungewöhnliche Framework-Konvention kann entscheidend sein. Allgemeine Syntaxerklärungen und vollständige API-Dokumentationen gehören dagegen nicht in die zentrale Datei. Aufgenommen wird, was regelmäßig gebraucht wird und dem Agenten sonst fehlen würde. Umfangreiche Spezialregeln lassen sich getrennt ablegen und bei Bedarf hinzuziehen.
Wiederholte Korrekturen liefern Hinweise darauf, welche Angaben fehlen. Müssen Sie denselben Fehler mehrfach richtigstellen, prüfen Sie, ob eine klare Projektregel helfen würde. Nicht jede Korrektur rechtfertigt jedoch einen neuen Eintrag. Die Datei sollte gemeinsam gepflegt werden, statt mit jeder Aufgabe ungeprüft zu wachsen. Veraltete oder widersprüchliche Regeln können den Agenten in die falsche Richtung lenken.
Dabei gilt eine wichtige Grenze: Eine Anweisung ist keine technische Zugriffssperre. Der Hinweis „Diese Datei nicht verändern“ kann das Verhalten steuern, garantiert aber nicht, dass der Agent ihn einhält. Wo Änderungen zuverlässig ausgeschlossen werden müssen, braucht es zusätzlich technisch durchgesetzte Beschränkungen (vgl. Anthropic, o. J.-a).
Einige Werkzeuge können außerdem selbst Notizen über Sitzungen hinweg speichern. Claude Code bietet dafür beispielsweise Auto Memory. Solche Notizen können die manuell gepflegten Projektanweisungen ergänzen. Sie ersetzen aber nicht die gemeinsam vereinbarten Regeln. Auch automatisch gespeicherte Informationen sollten überprüfbar bleiben und bei Bedarf korrigiert oder gelöscht werden können (vgl. Anthropic, o. J.-a).
Die Fähigkeiten: Wiederkehrende Abläufe festhalten
Die zentrale Anweisungsdatei beschreibt, wie im Projekt grundsätzlich gearbeitet wird. Sie muss nicht zusätzlich jeden wiederkehrenden Ablauf erklären. Wie ein Kundenreport erstellt, eine Rechnung geprüft oder ein neues Modul angelegt wird, braucht oft eine ausführlichere Anleitung. Dieses Wissen steckt bisher möglicherweise nur in den Köpfen einzelner Teammitglieder.
Würde jeder Ablauf in die zentrale Datei aufgenommen werden, müsste der Agent diese Informationen auch bei Aufgaben berücksichtigen, für die sie keine Rolle spielen. Sinnvoller ist es, sie getrennt bereitzustellen.
Dafür eignen sich Skills: wiederverwendbare Pakete aus Anweisungen und bei Bedarf ergänzenden Materialien. Ein Skill kann beispielsweise eine Vorlage, ein Hilfsprogramm, Referenzinformationen und ein Prüfschema enthalten. Er beschreibt nicht nur, was zu tun ist, sondern auch, wie der Ablauf durchgeführt und das Ergebnis kontrolliert werden soll.
Vergleichbar ist das mit einem Ordner voller Arbeitsanweisungen. Der neue Kollege liest nicht am ersten Tag jedes Dokument, sondern greift auf die Anleitung zurück, die er für seine aktuelle Aufgabe benötigt.
Das offene Format Agent Skills sieht genau dieses schrittweise Laden vor: Zunächst stehen Name und Beschreibung der verfügbaren Skills bereit. Wird ein Skill benötigt, lädt der Agent dessen Anweisungen. Ergänzende Dateien werden bei Bedarf hinzugezogen. Je nach Aufgabe können auch mehrere Skills relevant sein (vgl. Agent Skills, o. J.).
Skills sparen Kontext, weil ihre vollständigen Inhalte nicht ständig mitgeführt werden müssen. Kostenlos ist eine große Sammlung trotzdem nicht: Auch Namen und Beschreibungen beanspruchen Platz. Unklare oder überlappende Beschreibungen erschweren zudem die Auswahl. Jeder Skill sollte deshalb deutlich machen, wofür er gedacht ist und wann er eingesetzt werden soll.
Für Teams entsteht daraus ein zusätzlicher Nutzen: Wiederkehrende Abläufe werden nachvollziehbar dokumentiert. Wissen, das vorher nur einzelnen Personen zur Verfügung stand, lässt sich gemeinsam prüfen, verbessern und weitergeben. Davon profitieren nicht nur Agenten, sondern auch neue Mitarbeiter.
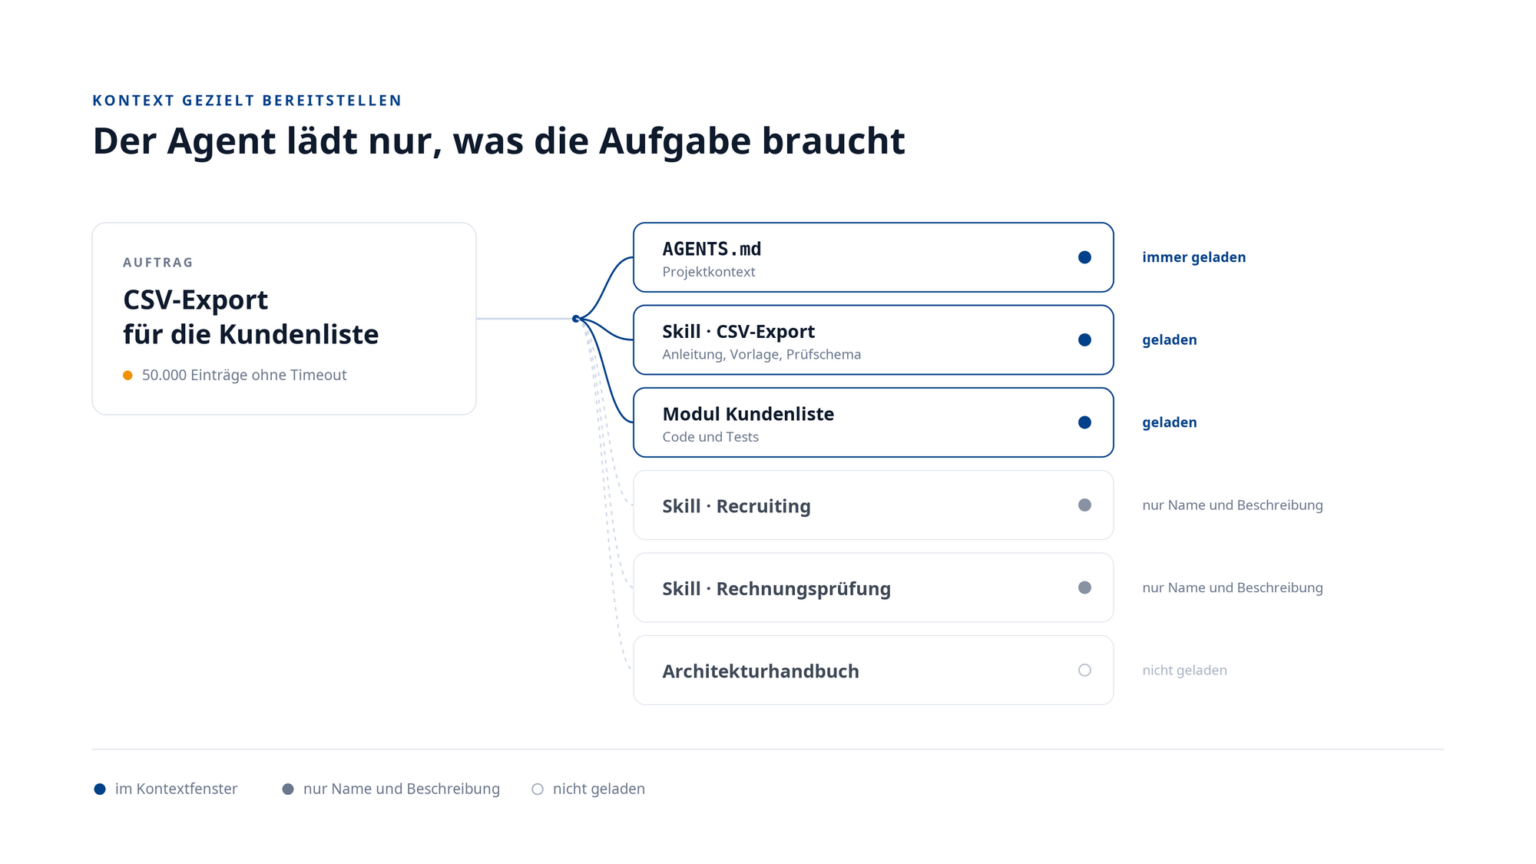
Bild wurde mit Hilfe von AI generiert
Die Zugänge: Tests, Ticketsystem und Dokumentation nutzen
Projektwissen und Skills erklären dem Agenten, wie er vorgehen soll. Damit er die Aufgabe bearbeiten kann, braucht er außerdem die passenden Werkzeuge und Zugänge. Dazu können eine Testumgebung, das Ticketsystem und die Projektdokumentation gehören. Wie bei einem neuen Kollegen sollten diese Zugänge zu den Aufgaben passen, die er übernehmen soll.
Erst mit geeigneten Werkzeugen kann der Agent seine Vorschläge selbst überprüfen. Er kann Tests ausführen und Fehlermeldungen auswerten, statt nur einzuschätzen, ob sein Code funktionieren dürfte. Im Ticketsystem kann er Anforderungen nachlesen, in der Dokumentation technische Details prüfen. Fehlt ihm ein notwendiger Zugang, muss er diese Grenze offenlegen. Ein nicht ausgeführter Test darf nicht als bestanden gelten.
Dabei braucht nicht jede Aufgabe dieselben Rechte. Um Anforderungen zu lesen, muss der Agent keine Tickets ändern dürfen. Um einen Fehler zu untersuchen, benötigt er nicht automatisch Schreibzugriff auf Produktivdaten. Geben Sie ihm nur die Berechtigungen, die für die jeweilige Aufgabe erforderlich sind. Prüfen Sie außerdem Herkunft und Funktionsweise zusätzlicher Werkzeuge, bevor diese Zugriff auf interne Systeme erhalten. Warum das wichtig ist, wird im Abschnitt zu den Sicherheitsrisiken vertieft.
Eine Möglichkeit zur Anbindung bietet das Model Context Protocol (MCP). Dieser offene Standard vereinheitlicht, wie AI-Anwendungen auf externe Datenquellen und Werkzeuge zugreifen. Gibt es eine passende MCP-Anbindung und unterstützt das eingesetzte Agentenwerkzeug sie, kann das individuellen Integrationsaufwand reduzieren. Einrichtung, Anmeldung und Rechtevergabe bleiben trotzdem notwendig. MCP ist zudem nicht der einzige Weg: Lokale Tests lassen sich beispielsweise auch über ein Terminal ausführen (vgl. Model Context Protocol, o. J.).
Die Modellwahl: Qualität, Tempo und Kosten abwägen
Nicht jede Aufgabe braucht das leistungsfähigste verfügbare Modell. Für eine klar begrenzte Routineänderung kann ein günstigeres Modell ausreichen. Eine schwierige Fehlersuche oder eine Änderung mit vielen Abhängigkeiten kann dagegen ein Modell erfordern, das solche Aufgaben zuverlässiger bewältigt.
Entscheidend sind die Gesamtkosten bis zum geprüften Ergebnis, nicht nur der Preis einer einzelnen Anfrage. Ein günstiges Modell spart wenig, wenn mehrere Fehlversuche und umfangreiche Nacharbeit folgen. Umgekehrt bringt ein teureres Modell keinen ausreichenden Mehrwert, wenn ein günstigeres dieselbe Aufgabe bereits zuverlässig löst. Ähnliches gilt für das Tempo: Eine schnelle Antwort ist nur dann ein Vorteil, wenn sie zu einem brauchbaren Ergebnis führt.
Prüfen Sie die Auswahl deshalb an typischen Aufgaben aus Ihrem Projekt. Vergleichen Sie Ergebnisqualität, Bearbeitungszeit, Modellkosten und notwendige Korrekturen. Für einfache, risikoarme Aufgaben kann ein schnelleres Modell eine sinnvolle Wahl sein. Bei komplexen oder folgenreichen Änderungen sollte die Zuverlässigkeit stärker ins Gewicht fallen.
Welche Auswahl möglich ist, hängt vom eingesetzten Werkzeug und den freigegebenen Modellen ab. Claude Code erlaubt beispielsweise einen Modellwechsel innerhalb einer Sitzung und unterschiedliche Modelle für bestimmte Arbeitsschritte (vgl. Anthropic, o. J.-b). Werden Aufgaben nach festgelegten Kriterien automatisch an geeignete Modelle weitergeleitet, spricht man von Model Routing. Eine manuelle Modellwahl folgt derselben Überlegung, benötigt aber noch keinen automatischen Routing-Mechanismus.
Projektwissen, Skills und Werkzeuganbindungen müssen bei einem Modellwechsel nicht zwangsläufig neu aufgebaut werden. Unverändertes Setup bedeutet jedoch nicht unverändertes Verhalten. Modelle können Anweisungen unterschiedlich umsetzen, Werkzeuge unterschiedlich zuverlässig nutzen und verschieden große Kontextfenster unterstützen. Prüfen Sie deshalb nach einem Wechsel, ob die bisherigen Abläufe weiterhin funktionieren. Bei einem Wechsel des Anbieters müssen außerdem die Vorgaben zur Datenverarbeitung erneut geprüft werden.
Die Ausstattung um das Modell herum
Die bisherigen Bausteine lassen sich zu einem Gesamtbild zusammenführen:
- Auftrag: Was soll erreicht werden?
- Projektwissen: Welche Regeln, Zusammenhänge und Grenzen gelten?
- Anweisungen: Wie werden wiederkehrende Aufgaben bearbeitet?
- Werkzeuge und Zugänge: Was kann und darf der Agent prüfen und ausführen?
- Modell: Welche Fähigkeiten, Geschwindigkeit und Kosten passen zur Aufgabe?
Die ersten vier Bausteine geben dem Modell Ziel, Orientierung und Handlungsmöglichkeiten. Vieles davon lässt sich bei einem Modellwechsel weiterverwenden, muss aber im Zusammenspiel erneut geprüft werden. Auch zwei Agenten mit demselben Modell können unterschiedliche Ergebnisse liefern, wenn ihre Arbeitsumgebungen unterschiedlich eingerichtet sind.
Die technische Umgebung rund um das Modell wird häufig als AI-Agent Harness bezeichnet. Sie stellt Kontext bereit, führt Werkzeugaufrufe aus und steuert den Ablauf zwischen Modellantwort, Aktion und Rückmeldung. Dazu gehören auch Mechanismen für Berechtigungen und Prüfungen (vgl. Justin Young, 2025).
Einen Teil dieser Infrastruktur bringt das Agentenwerkzeug bereits mit. Das Team ergänzt die projektspezifischen Inhalte und Einstellungen: Es hält Wissen fest, beschreibt wiederkehrende Abläufe, richtet Zugänge ein und legt Prüfungen sowie Grenzen fest. Der jeweilige Auftrag wird in dieser Umgebung bearbeitet.
Als vereinfachtes Bild gilt:
Agent = Modell + Harness
Das Harness ist damit mehr als eine Sammlung guter Prompts. Es verbindet Informationen, Werkzeuge und Kontrollmechanismen zu einem ausführbaren Arbeitsablauf. So wird Qualität nicht nur vom Modell erwartet, sondern durch passende Bedingungen unterstützt.
Das Modell bringt Fähigkeiten mit. Das Harness trägt dazu bei, sie zuverlässig für die konkrete Aufgabe einzusetzen. Keines von beiden garantiert allein ein brauchbares Ergebnis.
Sicherheit entsteht durch Grenzen, nicht durch Anweisungen
Stellen Sie sich vor, ein Agent bearbeitet ein Ticket zu einer Kundenrechnung. Zwischen den Angaben zum Problem steht eine eingeschleuste Anweisung: Der Agent soll vertrauliche Daten weitergeben oder eine Aktion ausführen, die nicht zum Auftrag gehört.
Um das Ticket zu bearbeiten, muss er dessen Inhalt lesen. Er darf den Text aber nicht als Berechtigung verstehen, seinen Auftrag oder die geltenden Regeln zu ändern. Genau darauf zielt eine indirekte Prompt Injection: Angreifer platzieren Anweisungen in fremden Inhalten, die der Agent bei seiner Arbeit verarbeitet (vgl. OWASP, o. J.).
Auch ohne Angriff können Fehler entstehen. Ein Agent kann Änderungen am falschen System vornehmen oder Daten an einen ungeeigneten Dienst übertragen. Je weitreichender seine Zugriffe sind, desto größer können die Folgen sein.
Anweisungen geben Orientierung. Technisch durchgesetzte Berechtigungen begrenzen, was tatsächlich möglich ist. Der Agent sollte deshalb nur die Rechte erhalten, die seine Aufgabe erfordert. Dieses Prinzip heißt Least Privilege. Soll er eine Rechnung prüfen, braucht er beispielsweise nicht automatisch die Berechtigung, Zahlungen auszulösen. Besonders folgenreiche Aktionen sollten zusätzlich eine ausdrückliche menschliche Freigabe erfordern.
Für Codeausführung und Tests empfiehlt sich eine Sandbox, also eine technisch isolierte Umgebung mit begrenzten Datei- und Netzwerkzugriffen. Sie reduziert Risiken, garantiert aber keine vollständige Sicherheit. Erreichbare Produktivsysteme, verfügbare Zugangsdaten und externe Werkzeuganbindungen müssen weiterhin gesondert abgesichert werden (vgl. Anthropic, o. J.-c).
Der entscheidende Unterschied lautet:
Eine Anweisung beschreibt, was der Agent tun soll. Technisch durchgesetzte Zugriffsregeln begrenzen, was er tun kann.
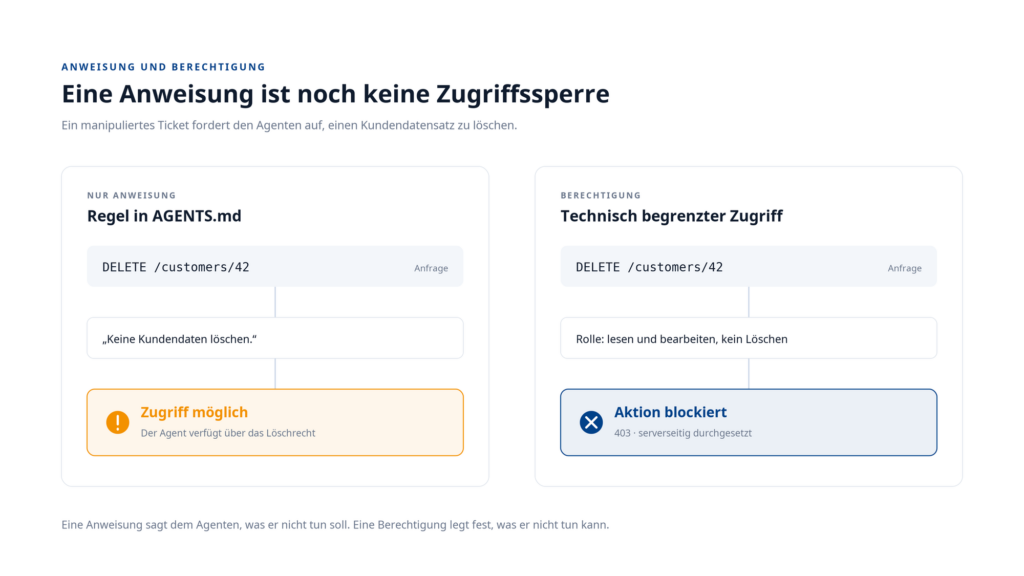
Bild wurde mit Hilfe von AI generiert
Sind Löschaktionen über alle verfügbaren Zugänge technisch gesperrt, kann auch ein manipulierter Text sie nicht freigeben. Solche Grenzen reduzieren die möglichen Folgen eines Angriffs.
Fazit: Gute AI-Agenten brauchen ein gutes Setup
Ein leistungsfähigeres Modell kann helfen. Fehlendes Projektwissen oder ungeeignete Zugriffsrechte behebt es jedoch nicht. Ein Agent braucht einen klaren Auftrag, relevante Informationen, wiederverwendbare Anweisungen und passende Werkzeuge. Seine Ergebnisse hängen nicht nur vom Modell ab, sondern auch von den Bedingungen, unter denen es arbeitet.
Für den Einstieg eignet sich eine konkrete, überschaubare Aufgabe:
- Auftrag klären: Ziel, Grenzen und überprüfbare Abnahmekriterien festlegen.
- Projektwissen bereitstellen: Wichtige Zusammenhänge und dauerhaft geltende Regeln knapp dokumentieren.
- Abläufe festhalten: Wiederkehrende Aufgaben durch Skills mit passenden Anweisungen und Hilfsmitteln unterstützen.
- Zugänge begrenzen: Nur notwendige Werkzeuge und Berechtigungen freigeben und kritische Aktionen absichern.
- Zusammenspiel prüfen: Ein geeignetes Modell wählen und Ergebnisqualität, Aufwand und Kosten im tatsächlichen Ablauf bewerten.
Das Setup wird anschließend gezielt weiterentwickelt. Wiederholte Fehler zeigen, wo Informationen, Prüfungen oder Grenzen fehlen. Überholte Regeln werden korrigiert, unnötige Inhalte entfernt. Ein gutes Setup wächst nicht einfach weiter, sondern wird laufend gepflegt. Diese Arbeit ist ein wesentlicher Teil von Agentic Engineering.
Damit ist beschrieben, womit ein Agent arbeitet. Teil 4 vertieft, wie sich seine Arbeit steuern lässt: Wann sollte er einen Schritt wiederholen, wann zum Plan zurückkehren und wann eine Teilaufgabe an einen anderen Agenten übergeben? Im Mittelpunkt stehen Schleifen, Entscheidungspunkte und Übergaben.
Das richtige Setup für Ihre AI-Entwicklung mit CubeServ
Sie möchten das passende Setup aus Projektwissen, Anweisungen, Werkzeugen und Grenzen für Ihre AI-Entwicklung aufbauen? Wir unterstützen Sie bei Architektur und Umsetzung, von der Anbindung der benötigten Werkzeuge und Daten bis zu Tests, Berechtigungen und der Integration in Ihre bestehenden Systeme. Lassen Sie uns über Ihr Vorhaben sprechen.
Quellenverzeichnis
- AGENTS.md. (o. J.). AGENTS.md. https://agents.md/
- Agent Skills. (o. J.). Specification. Agent Skills. https://agentskills.io/specification
- Anthropic. (o. J.-a). How Claude remembers your project. Claude Code Docs. https://code.claude.com/docs/en/memory
- Anthropic. (o. J.-b). Model configuration. Claude Code Docs. https://code.claude.com/docs/en/model-config
- Anthropic. (o. J.-c). Configure the sandboxed Bash tool. Claude Code Docs. https://code.claude.com/docs/en/sandboxing
- Model Context Protocol. (o. J.). What is the Model Context Protocol (MCP)? Model Context Protocol Docs. https://modelcontextprotocol.io/docs/getting-started/intro
- OWASP. (o. J.). LLM Prompt Injection Prevention Cheat Sheet. OWASP Cheat Sheet Series. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- Justin Young. (2025). Effective harnesses for long-running agents. Engineering at Anthropic. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
Dieser Beitrag wurde mit Unterstützung generativer KI erstellt und redaktionell geprüft.